爬虫本身是个中性工具
搜索服务靠爬虫收录页面,比价服务靠它同步价格,监控系统靠它检查站点可用性。这些抓取对站长来说大多是好事,没必要一律阻挡。问题出在另一部分:有人用同样的技术把整站内容抄走,有人高频请求把资源占满,还有人借抓取的名义试探漏洞。同一段代码,用在不同目的上,性质完全不同。
友好的爬虫长什么样
它们一般有几个特征:在请求头里明确声明自己的身份和联系方式;遵守站点在根目录下声明的抓取约定,不去碰被禁止的路径;控制请求频率,不会在短时间内把服务器压满;每次请求都有意义,不会反复抓取同一批已经拿到的页面。正规搜索的爬虫通常还会公开自己的地址段,方便站长做白名单校验。
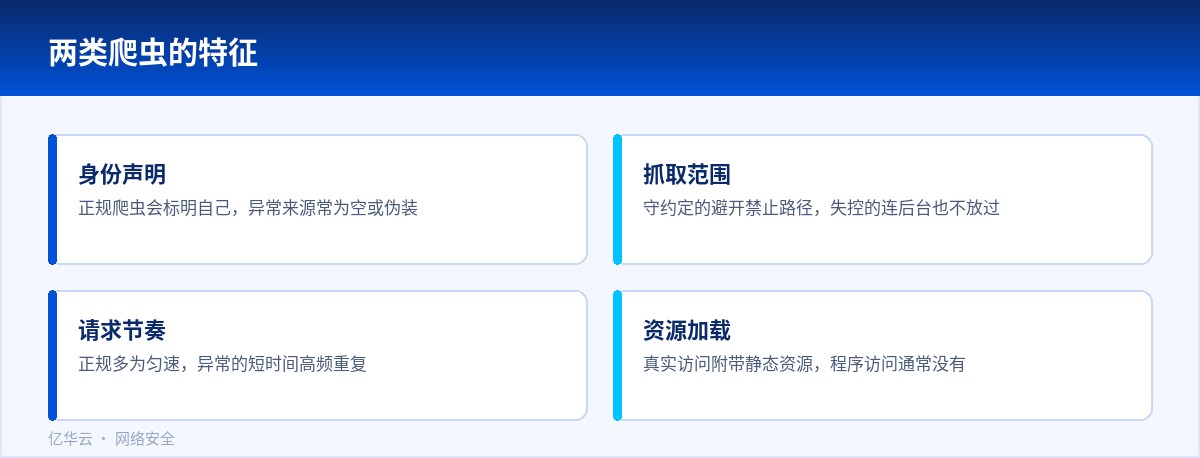
恶意爬虫的典型表现
最常见的特征是伪装:请求头写得像浏览器,但不加载任何图片和样式,只抓数据接口。其次是规律性太强,按编号从一递增遍历所有详情页,中间不休息,或者在很短的时间里把同一批页面重复抓取多次。再有就是范围失控,连后台地址、导出接口、搜索结果页都不放过,这些地方对正常抓取没有意义,却是数据泄露的高发位置。
用日志来区分
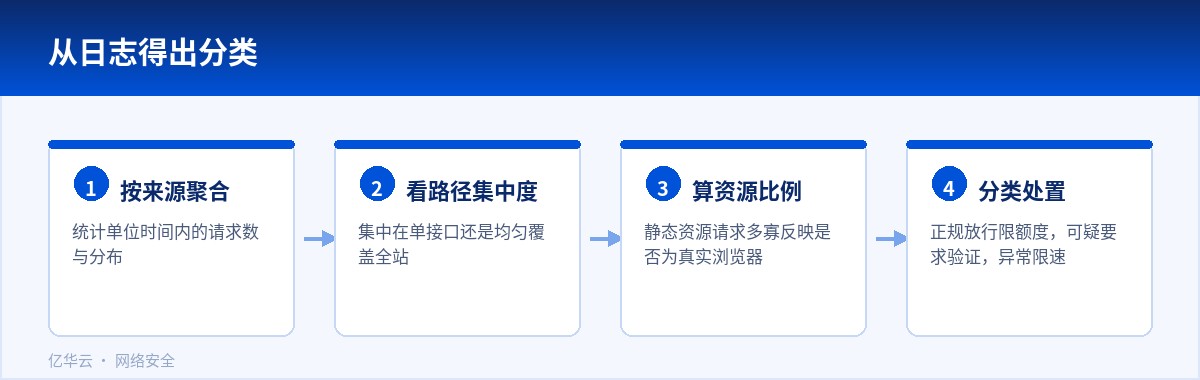
判断的起点是访问日志。先按来源聚合,看每个来源在单位时间内的请求数,再看它的路径分布是集中在某一个接口,还是均匀覆盖全站。接着看每请求的资源数量,真实浏览器打开一个页面会附带十几个静态资源请求,只调接口不加载资源的,基本可以判定为程序访问。
分开对待更有效
对正规爬虫,把它加入白名单并给一个合理的额度,让它按节奏收录,比一味封禁更有利。对拿不准来源的,可以先要求完成一次人机校验,通过之后再放行,真实用户几乎不会受影响。对已经确认在高速抓取数据的,做限速并设置自动过期,同时观察业务指标有没有波动。整套策略的目的不是把所有爬虫都挡住,而是把资源留给真正需要的人。
还有一层工作常被忽略:把不想被大量抓取的内容收进登录或权限之后。技术手段只能抬高抓取成本,把数据本身放在需要身份才能访问的位置,往往比反复调整规则更有效。
让规则有据可依
区分访客之前,先给自己的站点定一份说明文件。写明哪些目录可以抓取、哪些不必来、希望把频率控制在什么范围、联系方式是什么。规范的做法是放在站点根目录,路径固定,来访者一看就懂。这份文件不能强制谁遵守,但它给了你一个明确的依据:越界的访问可以理直气壮地处理。
对搜索引擎的正规来访者,还可以在后台做备案与验证,这样在工具里能看到对方抓取了哪些页面、有没有报错,比从日志里反推方便得多。对不愿意遵守说明、又持续高频拉取的来源,就用速率限制和来源限制去约束,而不是每天手动去封。
需要登录才能看到的内容,尽量不要靠隐藏链接来保护。真正的门是身份校验,而不是没人知道的地址。
把这些判断写下来,下次遇到流量异常时,就不必从头讨论一遍。
把经验留下
不是每个站点都需要一套复杂的区分方案。内容更新不频繁的站点,把静态资源交给缓存,动态页面加一层速率限制,基本就能应付常见的抓取压力。把力气花在正确的事情上,比追求参数好看更有价值。
需要长期运营的站点,建议从第一天就把日志留好,并给关键页面加上流量统计。有了历史数据,判断某次流量是不是异常就有参照,不必只凭当天的感觉。
每次处理完一次异常访问,花几分钟把特征、判断依据和处理动作记下来。积累几次之后,同类问题可以照着前一次的思路快速处理,也让接手的人少走弯路。
记录不必正式,放在同一个地方、能被搜到就够了。时间久了,这份记录本身就是最好的参考。
遇到一时判断不了的情况,先按观察处理,别急着下结论。




















